

Más herramientas
Casos de uso


La economía de los creadores tiene un problema de datos. El volumen de contenido social que se genera cada día es asombroso (se proyecta que sustente un mercado de 480 mil millones de dólares para 2027), y aun así acceder a esos datos nunca ha sido tan difícil. Las plataformas refuerzan sus jardines vallados. Las APIs oficiales limitan y restringen. Las herramientas de scraping se quedan obsoletas de la noche a la mañana.
Lo que hace que esto sea especialmente complicado para el desarrollo de IA es el cambio hacia flujos de trabajo agénticos. Los agentes de IA no consultan APIs de la forma en que los humanos hacen clic en botones. Toman decisiones probabilísticas y autónomas sobre qué datos obtener, cuándo obtenerlos y cómo encadenar resultados en múltiples llamadas a herramientas. También hay que tener en cuenta la brecha de descubrimiento. Es el desajuste fundamental entre la exploración a escala de IA y el acceso a datos condicionado por humanos.
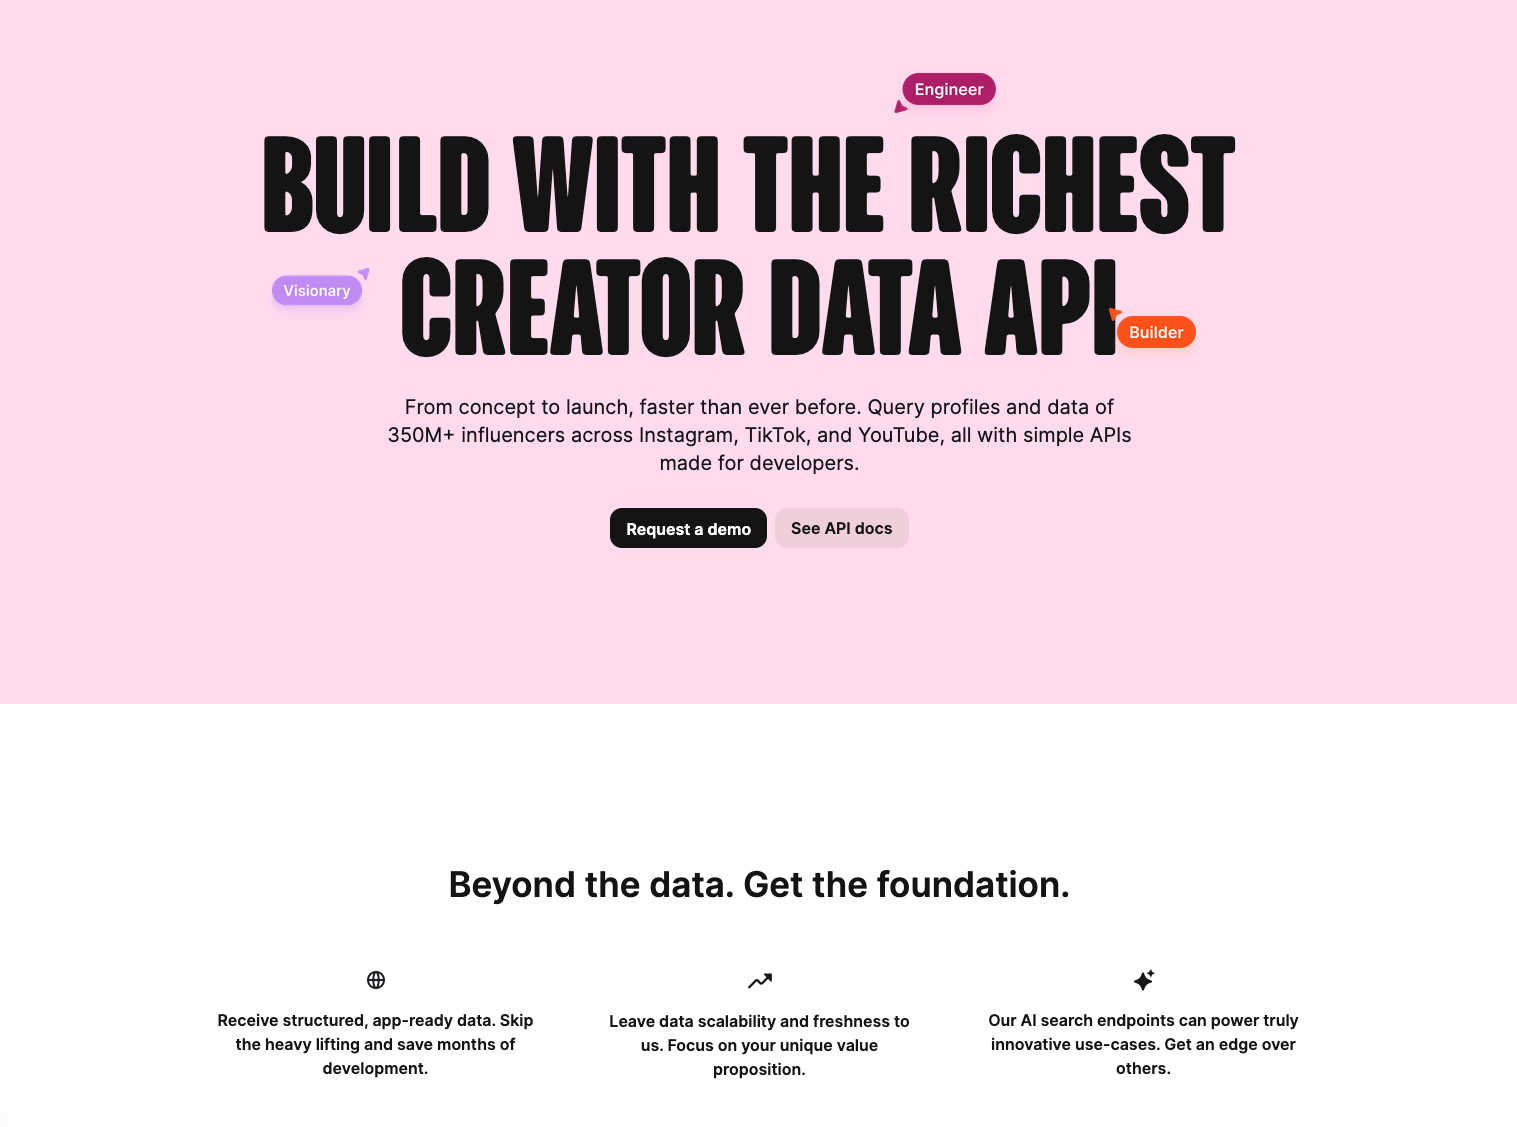
Modash funciona con una canalización que indexa continuamente más de 350 millones de perfiles en Instagram, TikTok y YouTube. Cuando un desarrollador o un agente de IA envía una consulta, la respuesta vuelve en milisegundos sobre una base de datos estructurada y ya optimizada. Es lo más parecido que ofrece el mercado a una capa de datos llave en mano para IA.
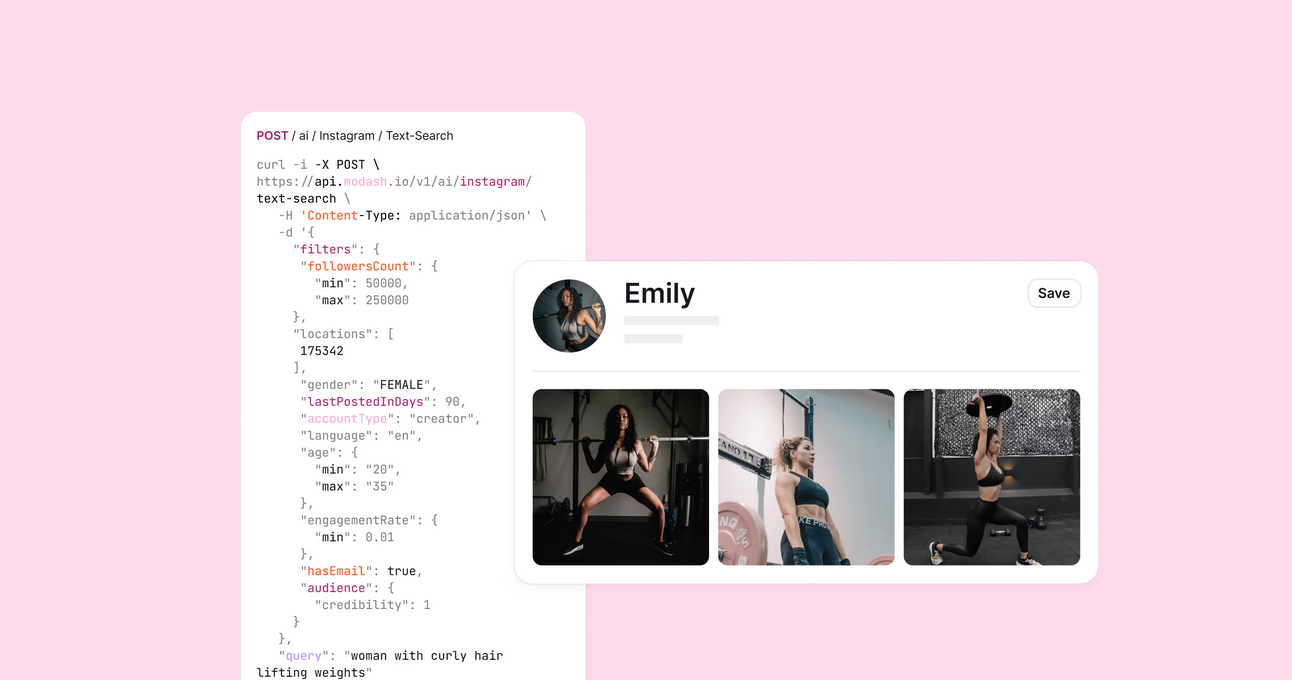
Vale la pena destacar específicamente la búsqueda semántica. Como Modash indexa el texto completo de biografías, pies de foto y hashtags junto con metadatos visuales, un agente puede consultar un concepto como "vida sostenible para madres trabajadoras en París" y encontrar creadores relevantes. El motor de perfiles similares amplía esto aún más: introduce un perfil semilla y la API devuelve creadores que son estadísticamente similares según la superposición del grafo y la similitud de contenido. También hay una configuración de API dual con una Discovery API preprocesada para recuperación RAG y un flujo masivo de Raw API para comentarios en vivo y metadatos de publicaciones.
Influencers.club cubre 340 millones de perfiles en 47 plataformas, incluidas Discord, Patreon, Twitch y Reddit. Está diseñado para equipos que necesitan una visión completa de la huella digital de un creador sin tener que unir decenas de integraciones independientes.
Data365 no es en absoluto una plataforma de marketing. Es una infraestructura de extracción. Entrega JSON no estructurado para publicaciones, comentarios y perfiles en Instagram, Twitter, Reddit, TikTok y LinkedIn.
HypeAuditor rastrea 219 millones de perfiles en cinco plataformas, utilizando modelos de ML entrenados específicamente para detectar interacción artificial. Para agentes de IA que crean listas de contacto de forma autónoma, el endpoint Audience Quality Score actúa como una barrera de calidad programática.
Storyclash aporta búsqueda visual neuronal al descubrimiento de creadores. Pasa una imagen de referencia o una URL de producto, y la API devuelve creadores que generan contenido visual y contextualmente similar. También archiva contenido como las Instagram Stories, lo que permite a los agentes de IA analizar ubicaciones temporales de campañas que, de otro modo, desaparecerían.
Influship adopta una postura diferente a la mayoría de los proveedores: acceso abierto con barreras mínimas de autenticación. Se centra en Instagram y rastrea alrededor de 5 millones de creadores, priorizando la velocidad y la búsqueda en lenguaje natural por encima de una amplia cobertura multiplataforma. La API está diseñada específicamente para alimentar programas de contacto escalables e integrarse en flujos de trabajo CRM personalizados con una configuración mínima.
Kuli es menos una API de datos y más un motor de inteligencia de descubrimiento. Su sistema Video Intelligence analiza el contenido fotograma a fotograma, extrayendo señales de calidad como tasas de visualización completa, trayectoria de producción y marcadores de autenticidad.
Phyllo es arquitectónicamente diferente de cualquier otro proveedor de esta lista. Es una puerta de enlace OAuth que requiere que el creador se autentique y otorgue al desarrollador acceso de primera parte a datos privados. Eso la convierte en la opción correcta para entornos críticos, como la conciliación de ingresos en tiempo real.
Elegir la API correcta es solo la mitad del problema. Cómo la conectas a un agente de IA importa tanto como eso. Incluir una llamada a una API REST en un prompt de texto plano y esperar que el LLM deduzca los parámetros es una vía segura hacia alucinaciones, valores inventados y créditos de API desperdiciados. Hay tres patrones que vale la pena conocer.
La puerta de enlace MCP
El enfoque más preparado para el futuro es crear un servidor MCP como intermediario estandarizado entre el LLM y la API de datos de creadores. En lugar de escribir wrappers personalizados dentro de la lógica de la aplicación, el servidor MCP expone endpoints de API como herramientas con nombre y esquemas definidos.
Llamada de herramientas y funciones
Para sistemas más pequeños y acotados, como un copiloto único dentro de la aplicación, la llamada directa a funciones es una opción razonable. Los LLM modernos están bien entrenados para generar esquemas JSON estructurados, por lo que envolver un endpoint de Influencers.club o Influship en una definición de función tipada suele funcionar.
Orquestación agente a agente (A2A)
Para flujos de trabajo más complejos, el patrón correcto es dividir el trabajo en microagentes especializados en lugar de cargar a un solo agente con toda la tarea. La configuración de doble API de Modash permite ejecutar una versión significativa de esto por completo dentro de un solo proveedor. Un Discovery Agent usa el endpoint de búsqueda semántica para extraer una lista estructurada de perfiles coincidentes a partir de una consulta conceptual. Luego, un Lookalike Agent selecciona el resultado con mejor rendimiento de esa lista, lo introduce en el motor lookalike y amplía el grupo con creadores estadísticamente similares.
Cada agente maneja una tarea más pequeña y enfocada, lo que reduce el riesgo de alucinaciones y facilita la depuración del sistema. Cuando el flujo de trabajo necesita ir más allá (puntuación de fraude, enriquecimiento de correos electrónicos, contacto), incorporas HypeAuditor o Influencers.club al final de la cadena.
La mayoría de los casos de uso remiten a uno de unos pocos proveedores. Aquí tienes la versión corta:
El reto de datos de la economía de creadores no va a desaparecer. Las plataformas seguirán restringiendo el acceso, la IA hará que el descubrimiento sea más valioso y el coste de mantenimiento del scraping no hará más que acumularse. La pereza arquitectónica sale cara en este entorno.
Los datos son a la vez una mercancía y una ventaja defensiva. Los equipos que ganan no son los que recopilan más datos. Son los que eligieron una arquitectura que les permite centrarse en construir lo que sus usuarios realmente valoran. No preguntes "¿Qué API es la más barata?" Pregunta "¿Qué API hace que mi agente de IA realmente funcione?"
Los jardines amurallados seguirán tapiando sus puertas. Tu elección de infraestructura de datos determina en qué lado del muro estás construyendo.
¿Listo para decidir? Empieza con créditos de prueba gratuitos: Reserva una llamada