

Meer tools
Toepassingen


De creator economy heeft een dataprobleem. De hoeveelheid social content die dagelijks wordt gegenereerd is duizelingwekkend (naar verwachting de basis van een markt van 480 miljard dollar in 2027), maar toegang tot die data is nog nooit zo moeilijk geweest. Platformen scherpen hun afgesloten ecosystemen aan. Officiële API's knijpen af en leggen beperkingen op. Scrapingtools verouderen van de ene op de andere dag.
Wat dit vooral lastig maakt voor AI-ontwikkeling, is de verschuiving naar agentische workflows. AI-agents bevragen API's niet op de manier waarop mensen op knoppen klikken. Ze nemen probabilistische, autonome beslissingen over welke data ze ophalen, wanneer ze die ophalen en hoe ze resultaten aan elkaar koppelen over meerdere toolaanroepen heen. Er is ook nog een discovery-kloof om over na te denken. Het is de fundamentele mismatch tussen verkenning op AI-schaal en door mensen afgeschermde datatoegang.
Modash draait op een pipeline die continu meer dan 350 miljoen profielen indexeert op Instagram, TikTok en YouTube. Wanneer een ontwikkelaar of een AI-agent een query indient, komt het antwoord binnen milliseconden terug vanuit een al geoptimaliseerde, gestructureerde database. Het is wat het dichtst in de buurt komt van een kant-en-klare datalaag voor AI op de markt.
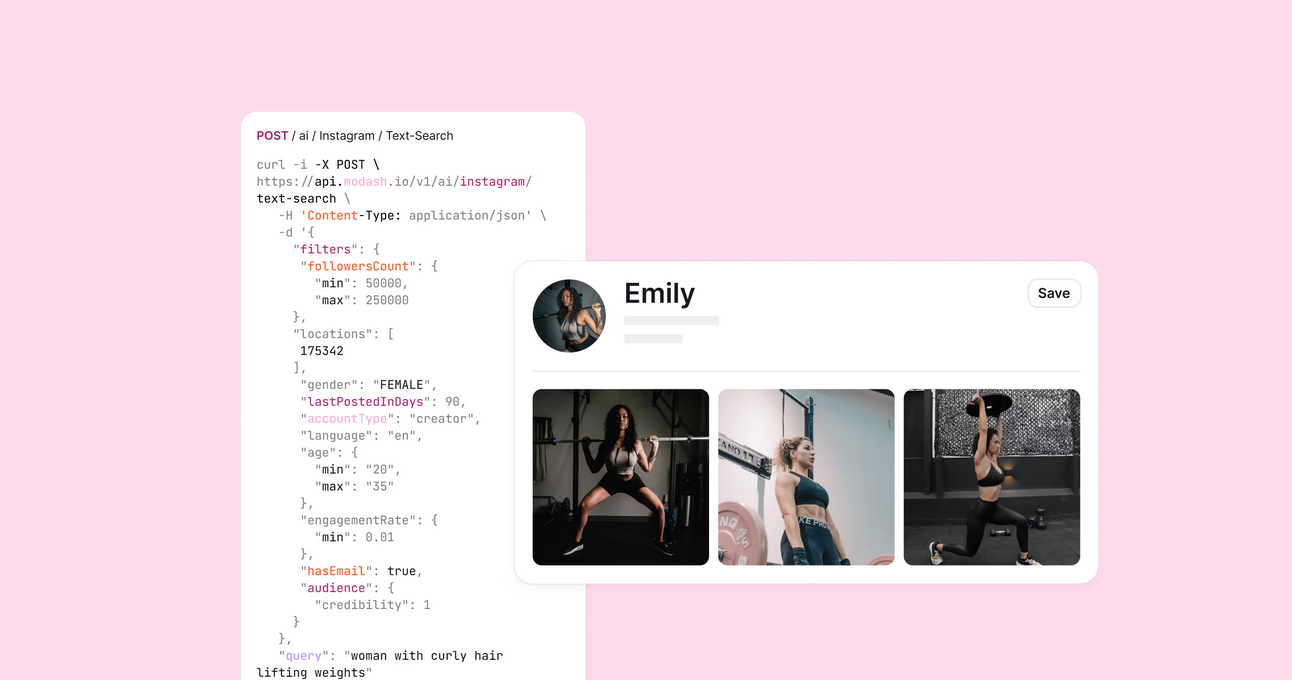
De semantische zoekfunctie is het waard om specifiek uit te lichten. Omdat Modash de volledige tekst van bio's, captions en hashtags indexeert naast visuele metadata, kan een agent zoeken op een concept als "duurzaam leven werkende moeders in Parijs" en relevante creators naar boven halen. De lookalike-engine trekt dit nog verder door: voer een seed-profiel in, en de API retourneert creators die statistisch vergelijkbaar zijn op basis van graafoverlap en contentgelijkenis. Er is ook een dubbele API-opzet met een vooraf verwerkte Discovery API voor RAG-retrieval en een Raw API-firehose voor live reacties en postmetadata.
Influencers.club dekt 340 miljoen profielen op 47 platformen, waaronder Discord, Patreon, Twitch en Reddit. Het is gebouwd voor teams die een compleet beeld nodig hebben van de digitale voetafdruk van een creator zonder tientallen losse integraties aan elkaar te hoeven knopen.
Data365 is helemaal geen marketingplatform. Het is een extractie-infrastructuur. Het levert ongestructureerde JSON voor posts, reacties en profielen op Instagram, Twitter, Reddit, TikTok en LinkedIn.
HypeAuditor volgt 219 miljoen profielen op vijf platforms, met ML-modellen die specifiek zijn getraind om kunstmatige engagement te detecteren. Voor AI-agents die autonoom outreachlijsten opbouwen, fungeert het Audience Quality Score-endpoint als een programmatische kwaliteitsdrempel.
Storyclash brengt neurale visuele zoekopdrachten naar creator discovery. Geef een referentieafbeelding of product-URL door, en de API retourneert creators die visueel en contextueel vergelijkbare content maken. Het archiveert ook content zoals Instagram Stories, waardoor AI-agents tijdelijke campagneplaatsingen kunnen analyseren die anders zouden verdwijnen.
Influship kiest een andere benadering dan de meeste aanbieders: open toegang met minimale authenticatiebarrières. Het richt zich op Instagram en volgt ongeveer 5 miljoen creators, waarbij snelheid en natuurlijke-taalzoekopdrachten voorrang krijgen boven brede cross-platformdekking. De API is specifiek ontworpen om schaalbare outreachprogramma's te voeden en met minimale configuratie in aangepaste CRM-workflows te passen.
Kuli is minder een data-API en meer een discovery-intelligence-engine. Het Video Intelligence-systeem analyseert content frame voor frame en haalt kwaliteitssignalen eruit, zoals uitkijkpercentages, productietraject en authenticiteitsmarkeringen.
Phyllo verschilt architectonisch van alle andere aanbieders op deze lijst. Het is een OAuth-gateway waarbij de creator zich moet authenticeren en de ontwikkelaar first-party toegang tot privédata moet verlenen. Daardoor is het de juiste keuze voor omgevingen met hoge inzet, zoals realtime omzetafstemming.
De juiste API kiezen is maar de helft van het probleem. Hoe je die met een AI-agent verbindt, is net zo belangrijk. Een REST API-call in een gewone tekstprompt zetten en hopen dat de LLM de parameters wel uitvogelt, is een betrouwbare weg naar hallucinaties, verzonnen waarden en verspilde API-credits. Er zijn drie patronen die het waard zijn om te kennen.
De MCP-gateway
De meest toekomstbestendige aanpak is het bouwen van een MCP-server als gestandaardiseerde tussenlaag tussen de LLM en de creator-data-API. In plaats van aangepaste wrappers binnen de applicatielogica te schrijven, stelt de MCP-server API-endpoints beschikbaar als benoemde tools met gedefinieerde schema's.
Tool- en function-calling
Voor kleinere, meer afgebakende systemen, zoals één enkele in-app copilot, is direct function calling een redelijke optie. Moderne LLM's zijn goed getraind in het genereren van gestructureerde JSON-schema's, dus een endpoint van Influencers.club of Influship verpakken in een getypte functiedefinitie werkt over het algemeen.
Agent-naar-agent (A2A)-orkestratie
Voor complexere workflows is het juiste patroon om de taak op te splitsen in gespecialiseerde micro-agents in plaats van één enkele agent met de volledige taak te belasten. De duale API-opzet van Modash maakt het mogelijk om hiervan een zinvolle versie volledig binnen één aanbieder uit te voeren. Een Discovery Agent gebruikt het semantic search-endpoint om een gestructureerde lijst met overeenkomende profielen op te halen op basis van een conceptquery. Een Lookalike Agent selecteert vervolgens het best presterende resultaat uit die lijst, voert het in de lookalike-engine in en breidt de pool uit met creators die er statistisch op lijken.
Elke agent behandelt een kleinere, gerichtere taak, waardoor het risico op hallucinaties afneemt en het systeem eenvoudiger te debuggen is. Wanneer de workflow verder moet gaan (fraudescores, e-mailverrijking, outreach), voeg je HypeAuditor of Influencers.club toe aan het einde van de keten.
De meeste use cases komen uit bij een van een handvol aanbieders. Hier is de korte versie:
De data-uitdaging van de creator economy verdwijnt niet. Platforms zullen de toegang blijven beperken, AI zal discovery waardevoller maken en de onderhoudskosten van scraping zullen alleen maar toenemen. Architectonische luiheid is duur in deze omgeving.
Data is zowel een commodity als een moat. De teams die winnen zijn niet degenen die er het meeste van verzamelen. Dat zijn de teams die een architectuur hebben gekozen waarmee ze zich kunnen richten op het bouwen van wat hun gebruikers echt waarderen. Vraag niet: "Welke API is het goedkoopst?" Vraag: "Welke API zorgt ervoor dat mijn AI-agent echt werkt?"
De ommuurde tuinen zullen hun poorten verder dichtmetselen. Je keuze voor data-infrastructuur bepaalt aan welke kant van de muur je bouwt.
Klaar om te beslissen? Ga aan de slag met gratis proefcredits: Plan een gesprek