

Mehr Tools
Use Cases
Rechtliches


Die Creator Economy hat ein Datenproblem. Das Volumen an Social-Content, das täglich erzeugt wird, ist enorm (voraussichtlich die Grundlage für einen 480-Milliarden-Dollar-Markt bis 2027), doch der Zugang zu diesen Daten war noch nie schwieriger. Plattformen schotten ihre geschlossenen Ökosysteme immer stärker ab. Offizielle APIs drosseln und schränken ein. Scraping-Tools veralten über Nacht.
Was dies für die KI-Entwicklung besonders schwierig macht, ist die Verlagerung hin zu agentischen Workflows. KI-Agenten fragen APIs nicht so ab, wie Menschen auf Buttons klicken. Sie treffen probabilistische, autonome Entscheidungen darüber, welche Daten abgerufen werden, wann sie abgerufen werden und wie Ergebnisse über mehrere Tool-Aufrufe hinweg verknüpft werden. Es gibt auch eine Entdeckungslücke, die berücksichtigt werden muss. Sie ist die grundlegende Diskrepanz zwischen Exploration im KI-Maßstab und menschlich beschränktem Datenzugang.
Modash läuft auf einer Pipeline, die kontinuierlich über 350 Millionen Profile auf Instagram, TikTok und YouTube indexiert. Wenn ein Entwickler oder ein KI-Agent eine Abfrage sendet, kommt die Antwort innerhalb von Millisekunden aus einer bereits optimierten, strukturierten Datenbank zurück. Es ist das, was einem schlüsselfertigen Daten-Layer für KI auf dem Markt am nächsten kommt.
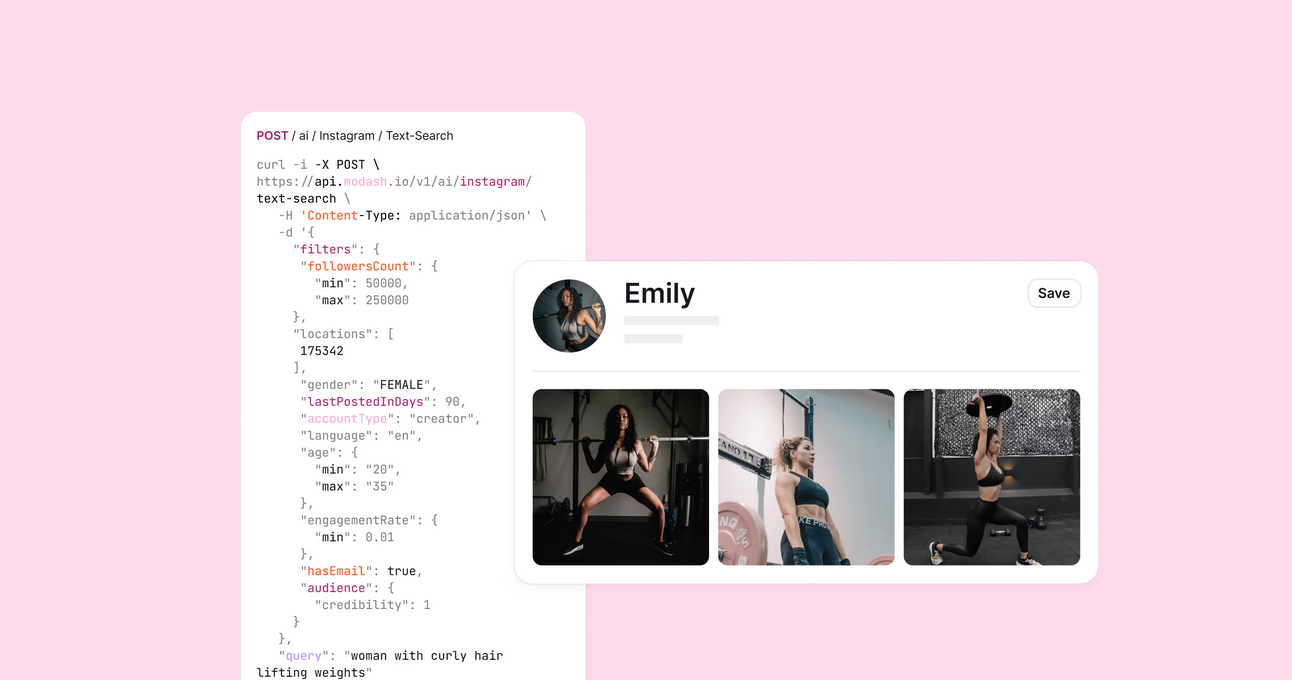
Die semantische Suche ist besonders hervorzuheben. Da Modash den vollständigen Text von Biografien, Captions und Hashtags zusammen mit visuellen Metadaten indexiert, kann ein Agent nach einem Konzept wie "nachhaltig lebende berufstätige Mütter in Paris" suchen und relevante Creator finden. Die Lookalike-Engine führt das noch weiter: Gibt man ein Ausgangsprofil ein, liefert die API Creator zurück, die auf Basis von Graphenüberschneidungen und Inhaltsähnlichkeit statistisch ähnlich sind. Es gibt außerdem ein duales API-Setup mit einer vorverarbeiteten Discovery API für RAG-Abruf und einem Raw API-Firehose für Live-Kommentare und Post-Metadaten.
Influencers.club deckt 340 Millionen Profile auf 47 Plattformen ab, darunter Discord, Patreon, Twitch und Reddit. Es ist für Teams konzipiert, die eine vollständige Sicht auf den digitalen Fußabdruck eines Creators benötigen, ohne Dutzende separater Integrationen zusammenfügen zu müssen.
Data365 ist überhaupt keine Marketingplattform. Es ist eine Extraktionsinfrastruktur. Es liefert unstrukturiertes JSON für Posts, Kommentare und Profile über Instagram, Twitter, Reddit, TikTok und LinkedIn hinweg.
HypeAuditor verfolgt 219 Millionen Profile über fünf Plattformen hinweg und verwendet ML-Modelle, die speziell zur Erkennung künstlichen Engagements trainiert wurden. Für KI-Agenten, die autonom Outreach-Listen erstellen, fungiert der Audience Quality Score-Endpunkt als programmatische Qualitätsschranke.
Storyclash bringt neuronale visuelle Suche in die Creator-Discovery. Übergeben Sie ein Referenzbild oder eine Produkt-URL, und die API liefert Creator zurück, die visuell und kontextuell ähnliche Inhalte erstellen. Es archiviert auch Inhalte wie Instagram Stories und ermöglicht KI-Agenten damit, temporäre Kampagnenplatzierungen zu analysieren, die sonst verschwinden würden.
Influship vertritt eine andere Haltung als die meisten Anbieter: offener Zugang mit minimalen Authentifizierungsbarrieren. Es konzentriert sich auf Instagram und verfolgt rund 5 Millionen Creator, wobei Geschwindigkeit und Suche in natürlicher Sprache Vorrang vor breiter plattformübergreifender Abdeckung haben. Die API ist speziell darauf ausgelegt, skalierbare Outreach-Programme zu speisen und sich mit minimalem Einrichtungsaufwand in benutzerdefinierte CRM-Workflows einzufügen.
Kuli ist weniger eine Daten-API als vielmehr eine Discovery-Intelligence-Engine. Sein Video-Intelligence-System analysiert Inhalte Frame für Frame und extrahiert Qualitätssignale wie Abschlussraten beim Ansehen, Produktionsverlauf und Authentizitätsmarker.
Phyllo unterscheidet sich architektonisch von allen anderen Anbietern auf dieser Liste. Es ist ein OAuth-Gateway, das verlangt, dass sich der Creator authentifiziert und dem Entwickler First-Party-Zugriff auf private Daten gewährt. Das macht es zur richtigen Wahl für Umgebungen mit hohen Anforderungen wie die Umsatzabstimmung in Echtzeit.
Die richtige API auszuwählen, ist nur die halbe Herausforderung. Wie Sie sie mit einem KI-Agenten verbinden, ist genauso wichtig. Einen REST-API-Aufruf in einen reinen Text-Prompt einzufügen und zu hoffen, dass das LLM die Parameter schon herausfindet, ist ein verlässlicher Weg zu Halluzinationen, erfundenen Werten und verbrannten API-Credits. Es gibt drei Muster, die man kennen sollte.
Das MCP-Gateway
Der zukunftssicherste Ansatz besteht darin, einen MCP-Server als standardisierten Vermittler zwischen dem LLM und der Creator-Daten-API zu bauen. Anstatt benutzerdefinierte Wrapper innerhalb der Anwendungslogik zu schreiben, stellt der MCP-Server API-Endpunkte als benannte Tools mit definierten Schemas bereit.
Tool- und Function-Calling
Für kleinere, stärker abgegrenzte Systeme, etwa einen einzelnen In-App-Copiloten, ist direktes Function-Calling eine vernünftige Option. Moderne LLMs sind gut darauf trainiert, strukturierte JSON-Schemas auszugeben, daher funktioniert es in der Regel, einen Endpunkt von Influencers.club oder Influship in eine typisierte Funktionsdefinition zu kapseln.
Agent-zu-Agent-(A2A)-Orchestrierung
Für komplexere Workflows besteht das richtige Muster darin, die Aufgabe in spezialisierte Mikro-Agenten aufzuteilen, anstatt einen einzelnen Agenten mit der gesamten Aufgabe zu belasten. Das duale API-Setup von Modash ermöglicht es, eine sinnvolle Version davon vollständig innerhalb eines einzigen Anbieters auszuführen. Ein Discovery Agent nutzt den Endpunkt für semantische Suche, um auf Basis einer Konzeptabfrage eine strukturierte Liste passender Profile abzurufen. Ein Lookalike Agent wählt dann das leistungsstärkste Ergebnis aus dieser Liste aus, speist es in die Lookalike-Engine ein und erweitert den Pool um Creator, die ihm statistisch ähnlich sind.
Jeder Agent übernimmt eine kleinere, stärker fokussierte Aufgabe, was das Risiko von Halluzinationen verringert und das System leichter debuggen lässt. Wenn der Workflow weitergehen muss (Betrugs-Scoring, E-Mail-Enrichment, Outreach), ergänzen Sie am Ende der Kette HypeAuditor oder Influencers.club.
Die meisten Anwendungsfälle führen zurück zu einem von wenigen Anbietern. Hier ist die Kurzfassung:
Die Datenherausforderung der Creator Economy wird nicht verschwinden. Plattformen werden den Zugang weiter einschränken, KI wird Discovery wertvoller machen, und die Wartungskosten des Scrapings werden sich nur weiter summieren. Architektonische Trägheit ist in diesem Umfeld teuer.
Daten sind sowohl eine Commodity als auch ein Burggraben. Die Teams, die gewinnen, sind nicht diejenigen, die am meisten davon sammeln. Es sind diejenigen, die eine Architektur gewählt haben, die es ihnen ermöglicht, sich auf den Aufbau dessen zu konzentrieren, was ihre Nutzer tatsächlich schätzen. Fragen Sie nicht: "Welche API ist am günstigsten?" Fragen Sie: "Welche API sorgt dafür, dass mein KI-Agent tatsächlich funktioniert?"
Die abgeschotteten Ökosysteme werden ihre Tore weiter zumauern. Ihre Wahl der Dateninfrastruktur bestimmt, auf welcher Seite der Mauer Sie bauen.
Bereit für die Entscheidung? Starten Sie mit kostenlosen Testguthaben: Gespräch buchen