

Narzędzia
Zastosowania


Ekonomia twórców ma problem z danymi. Skala treści publikowanych codziennie w mediach społecznościowych jest oszałamiająca (prognozuje się, że do 2027 roku będzie stanowić fundament rynku wartego 480 miliardów dolarów), a mimo to dostęp do tych danych nigdy nie był trudniejszy. Platformy coraz mocniej zamykają swoje ekosystemy. Oficjalne API ograniczają przepustowość i dostęp. Narzędzia do scrapingu dezaktualizują się z dnia na dzień.
To, co czyni to szczególnie trudnym w rozwoju AI, to zwrot w stronę przepływów pracy opartych na agentach. Agenci AI nie wysyłają zapytań do API w taki sposób, w jaki ludzie klikają przyciski. Podejmują probabilistyczne, autonomiczne decyzje o tym, jakie dane pobrać, kiedy je pobrać i jak łączyć wyniki z wielu wywołań narzędzi. Warto też pamiętać o luce w obszarze odkrywania danych. To fundamentalne niedopasowanie między eksploracją na skalę AI a dostępem do danych ograniczanym przez człowieka.
Modash działa w oparciu o pipeline, który stale indeksuje ponad 350 milionów profili na Instagramie, TikToku i YouTube. Gdy deweloper lub agent AI wysyła zapytanie, odpowiedź wraca w ciągu milisekund z już zoptymalizowanej, ustrukturyzowanej bazy danych. To rozwiązanie najbliższe temu, co rynek ma do zaoferowania jako gotową warstwę danych dla AI.
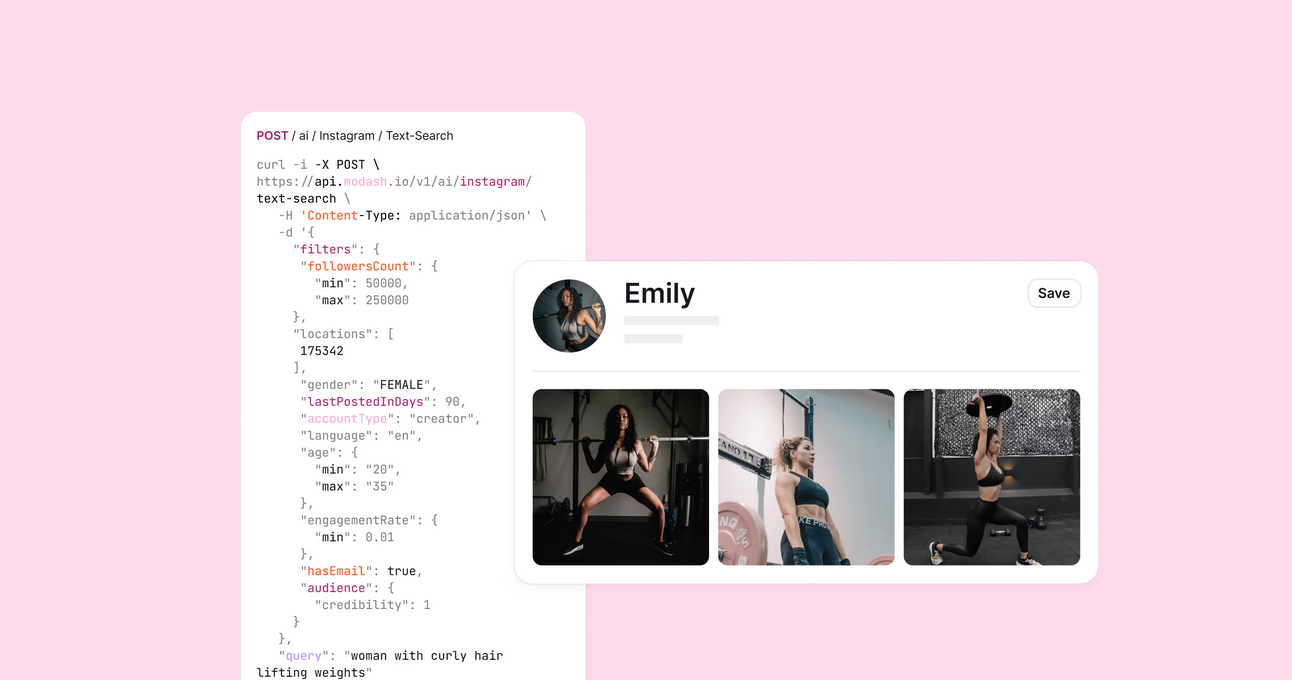
Na szczególną uwagę zasługuje wyszukiwanie semantyczne. Ponieważ Modash indeksuje pełną treść bio, podpisów i hashtagów wraz z metadanymi wizualnymi, agent może wysłać zapytanie dotyczące koncepcji takiej jak "zrównoważony styl życia pracujących mam w Paryżu" i znaleźć pasujących twórców. Silnik lookalike rozwija to jeszcze dalej: podaj profil źródłowy, a API zwróci twórców statystycznie podobnych na podstawie nakładania się grafów i podobieństwa treści. Dostępna jest też podwójna konfiguracja API: wstępnie przetworzone Discovery API do pobierania RAG oraz strumień Raw API dla komentarzy na żywo i metadanych postów.
Influencers.club obejmuje 340 milionów profili na 47 platformach, w tym Discordzie, Patreonie, Twitchu i Reddicie. To rozwiązanie stworzone dla zespołów, które potrzebują pełnego obrazu cyfrowego śladu twórcy bez łączenia dziesiątek oddzielnych integracji.
Data365 w ogóle nie jest platformą marketingową. To infrastruktura do ekstrakcji danych. Dostarcza nieustrukturyzowany JSON dla postów, komentarzy i profili na Instagramie, Twitterze, Reddicie, TikToku i LinkedIn.
HypeAuditor śledzi 219 milionów profili na pięciu platformach, wykorzystując modele ML trenowane specjalnie do wykrywania sztucznego zaangażowania. W przypadku agentów AI, które autonomicznie budują listy outreachowe, endpoint Audience Quality Score działa jako programistyczna bramka jakości.
Storyclash wnosi neuronowe wyszukiwanie wizualne do odkrywania twórców. Przekaż obraz referencyjny lub URL produktu, a API zwróci twórców tworzących treści podobne wizualnie i kontekstowo. Archiwizuje też treści takie jak Instagram Stories, umożliwiając agentom AI analizę tymczasowych placementów kampanii, które w innym przypadku by zniknęły.
Influship przyjmuje inne podejście niż większość dostawców: otwarty dostęp z minimalnymi barierami uwierzytelniania. Koncentruje się na Instagramie i śledzi około 5 milionów twórców, stawiając na szybkość i wyszukiwanie w języku naturalnym zamiast szerokiego, międzyplatformowego zasięgu. API zostało zaprojektowane specjalnie po to, by zasilać skalowalne programy outreachowe i wpinać się w niestandardowe workflow CRM przy minimalnej konfiguracji.
Kuli jest mniej data API, a bardziej silnikiem inteligencji do discovery. Jego system Video Intelligence analizuje treści klatka po klatce, wyodrębniając sygnały jakości, takie jak wskaźniki obejrzenia do końca, trajektoria produkcyjna i wskaźniki autentyczności.
Phyllo różni się architektonicznie od każdego innego dostawcy na tej liście. To bramka OAuth, która wymaga od twórcy uwierzytelnienia się i przyznania deweloperowi dostępu first-party do prywatnych danych. Dlatego jest to właściwy wybór dla środowisk o wysokiej stawce, takich jak uzgadnianie przychodów w czasie rzeczywistym.
Wybór właściwego API to tylko połowa problemu. Równie ważne jest to, jak połączysz je z agentem AI. Wrzuć wywołanie REST API do zwykłego promptu tekstowego i licz na to, że LLM sam odgadnie parametry, a otrzymasz niezawodną drogę do halucynacji, zmyślonych wartości i przepalonych kredytów API. Warto znać trzy wzorce.
Bramka MCP
Najbardziej przyszłościowym podejściem jest zbudowanie serwera MCP jako standaryzowanego pośrednika między LLM a API danych o twórcach. Zamiast pisać niestandardowe wrappery wewnątrz logiki aplikacji, serwer MCP udostępnia endpointy API jako nazwane narzędzia ze zdefiniowanymi schematami.
Wywoływanie narzędzi i funkcji
W mniejszych, bardziej zamkniętych systemach, takich jak pojedynczy copilot w aplikacji, bezpośrednie wywoływanie funkcji jest rozsądną opcją. Nowoczesne LLM są dobrze wytrenowane do zwracania ustrukturyzowanych schematów JSON, więc opakowanie endpointu Influencers.club lub Influship w definicję typowanej funkcji zazwyczaj działa.
Orkiestracja agent-agent (A2A)
W bardziej złożonych workflow właściwym wzorcem jest podzielenie zadania na wyspecjalizowanych mikroagentów zamiast obciążania jednego agenta całym zadaniem. Podwójna konfiguracja API Modash umożliwia uruchomienie sensownej wersji tego podejścia całkowicie w ramach jednego dostawcy. Discovery Agent używa endpointu wyszukiwania semantycznego, aby pobrać uporządkowaną listę pasujących profili na podstawie zapytania koncepcyjnego. Lookalike Agent wybiera następnie najlepiej działający wynik z tej listy, przekazuje go do silnika lookalike i rozszerza pulę o twórców statystycznie do niego podobnych.
Każdy agent obsługuje mniejsze, bardziej skoncentrowane zadanie, zmniejszając ryzyko halucynacji i ułatwiając debugowanie systemu. Gdy workflow musi pójść dalej (scoring oszustw, enrichment e-maili, outreach), na końcu łańcucha dodajesz HypeAuditor lub Influencers.club.
Większość przypadków użycia sprowadza się do jednego z kilku dostawców. Oto krótka wersja:
Wyzwanie związane z danymi w creator economy nie zniknie. Platformy będą nadal ograniczać dostęp, AI sprawi, że discovery będzie jeszcze cenniejsze, a koszt utrzymania scrapingu będzie tylko narastał. Architektoniczne lenistwo jest kosztowne w takim środowisku.
Dane są jednocześnie towarem i fosą ochronną. Wygrywają nie te zespoły, które zbierają ich najwięcej. To te, które wybrały architekturę pozwalającą skupić się na budowaniu tego, co ich użytkownicy naprawdę cenią. Nie pytaj: "Które API jest najtańsze?" Zapytaj: "Które API sprawi, że mój agent AI będzie naprawdę działał?"
Zamknięte ogrody będą nadal zamurowywać swoje bramy. To, po której stronie muru budujesz, zależy od wyboru infrastruktury danych.
Gotowy, by podjąć decyzję? Zacznij od bezpłatnych kredytów próbnych: Umów rozmowę