

Mais opções
Aplicações


A creator economy tem um problema de dados. O volume de conteúdo social gerado diariamente é impressionante (com previsão de sustentar um mercado de US$ 480 bilhões até 2027), mas o acesso a esses dados nunca foi tão difícil. As plataformas reforçam seus jardins murados. As APIs oficiais impõem limites e restrições. As ferramentas de scraping envelhecem da noite para o dia.
O que torna isso especialmente complicado para o desenvolvimento de IA é a mudança em direção a fluxos de trabalho agentivos. Agentes de IA não consultam APIs da mesma forma que humanos clicam em botões. Eles tomam decisões probabilísticas e autônomas sobre quais dados buscar, quando buscá-los e como encadear resultados em várias chamadas de ferramentas. Também há a lacuna de descoberta a considerar. É o descompasso fundamental entre a exploração em escala de IA e o acesso a dados controlado por humanos.
Modash funciona com um pipeline que indexa continuamente mais de 350 milhões de perfis no Instagram, TikTok e YouTube. Quando um desenvolvedor ou um agente de IA envia uma consulta, a resposta retorna em milissegundos a partir de um banco de dados estruturado e já otimizado. É o mais próximo que o mercado tem de uma camada de dados pronta para uso para IA.
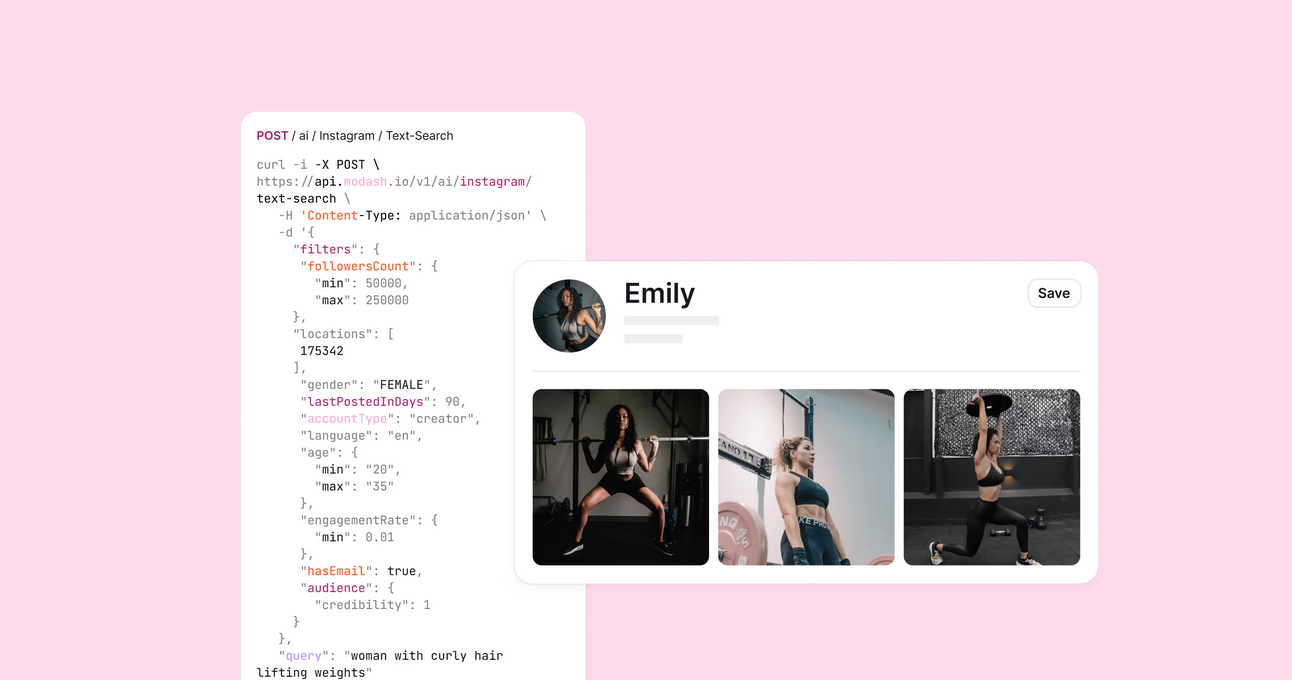
Vale destacar especificamente a busca semântica. Como a Modash indexa o texto completo de bios, legendas e hashtags junto com metadados visuais, um agente pode consultar um conceito como "mães trabalhadoras em Paris com vida sustentável" e encontrar creators relevantes. O mecanismo de lookalike vai além: insira um perfil de referência, e a API retorna creators estatisticamente semelhantes com base na sobreposição de grafos e na similaridade de conteúdo. Há também uma configuração de API dupla com uma Discovery API pré-processada para recuperação RAG e um fluxo contínuo da Raw API para comentários ao vivo e metadados de posts.
O Influencers.club cobre 340 milhões de perfis em 47 plataformas, incluindo Discord, Patreon, Twitch e Reddit. Foi criado para equipes que precisam de uma visão completa da pegada digital de um creator sem ter de unir dezenas de integrações separadas.
Data365 não é uma plataforma de marketing de forma alguma. É uma infraestrutura de extração. Ela entrega JSON não estruturado para posts, comentários e perfis em Instagram, Twitter, Reddit, TikTok e LinkedIn.
A HypeAuditor rastreia 219 milhões de perfis em cinco plataformas, usando modelos de ML treinados especificamente para detectar engajamento artificial. Para agentes de IA que criam listas de prospecção de forma autônoma, o endpoint Audience Quality Score atua como um filtro de qualidade programático.
A Storyclash traz busca visual neural para a descoberta de creators. Envie uma imagem de referência ou a URL de um produto, e a API retorna creators que geram conteúdo visual e contextualmente semelhante. Ela também arquiva conteúdos como Instagram Stories, permitindo que agentes de IA analisem posicionamentos temporários de campanha que, de outra forma, desapareceriam.
A Influship adota uma postura diferente da maioria dos provedores: acesso aberto com barreiras mínimas de autenticação. Ela se concentra no Instagram e rastreia cerca de 5 milhões de creators, priorizando velocidade e busca em linguagem natural em vez de ampla cobertura multiplataforma. A API foi projetada especificamente para alimentar programas de prospecção escaláveis e se encaixar em fluxos de trabalho de CRM personalizados com configuração mínima.
A Kuli é menos uma API de dados e mais um motor de inteligência para descoberta. Seu sistema de Video Intelligence analisa o conteúdo quadro a quadro, extraindo sinais de qualidade como taxas de conclusão de visualização, trajetória de produção e marcadores de autenticidade.
A Phyllo é arquitetonicamente diferente de todos os outros provedores desta lista. É um gateway OAuth que exige que o creator se autentique e conceda ao desenvolvedor acesso first-party a dados privados. Isso a torna a escolha certa para ambientes de alto risco, como reconciliação de receita em tempo real.
Escolher a API certa é apenas metade do problema. Como você a conecta a um agente de IA importa tanto quanto. Inserir uma chamada de API REST em um prompt de texto simples e esperar que o LLM descubra os parâmetros é um caminho confiável para alucinações, valores inventados e créditos de API desperdiçados. Há três padrões que vale a pena conhecer.
O gateway MCP
A abordagem mais preparada para o futuro é construir um servidor MCP como intermediário padronizado entre o LLM e a API de dados de creators. Em vez de escrever wrappers personalizados dentro da lógica da aplicação, o servidor MCP expõe endpoints de API como ferramentas nomeadas com esquemas definidos.
Chamadas de ferramentas e funções
Para sistemas menores e mais contidos, como um único copiloto no app, chamadas diretas de função são uma opção razoável. Os LLMs modernos são bem treinados para produzir esquemas JSON estruturados, então encapsular um endpoint do Influencers.club ou da Influship em uma definição de função tipada geralmente funciona.
Orquestração agent-to-agent (A2A)
Para fluxos de trabalho mais complexos, o padrão certo é dividir o trabalho em microagentes especializados, em vez de sobrecarregar um único agente com a tarefa inteira. A configuração de API dupla da Modash permite executar uma versão significativa disso inteiramente dentro de um único provedor. Um Discovery Agent usa o endpoint de busca semântica para extrair uma lista estruturada de perfis correspondentes com base em uma consulta conceitual. Um Lookalike Agent então seleciona o resultado de melhor desempenho dessa lista, o alimenta no mecanismo lookalike e expande o conjunto com creators estatisticamente semelhantes a ele.
Cada agente lida com uma tarefa menor e mais focada, reduzindo o risco de alucinações e tornando o sistema mais fácil de depurar. Quando o fluxo de trabalho precisa ir além (pontuação de fraude, enrichment de e-mail, prospecção), você adiciona HypeAuditor ou Influencers.club ao fim da cadeia.
A maioria dos casos de uso remete a um pequeno grupo de provedores. Aqui está a versão curta:
O desafio de dados da creator economy não vai desaparecer. As plataformas continuarão restringindo o acesso, a IA tornará a descoberta mais valiosa e o custo de manutenção do scraping só vai se acumular. Preguiça arquitetural sai caro nesse ambiente.
Dados são ao mesmo tempo uma commodity e um fosso competitivo. As equipes que vencem não são as que coletam mais dados. São as que escolheram uma arquitetura que lhes permite focar em construir o que seus usuários realmente valorizam. Não pergunte "Qual API é a mais barata?" Pergunte "Qual API faz meu agente de IA realmente funcionar?"
Os jardins murados continuarão fechando ainda mais seus portões. Sua escolha de infraestrutura de dados determina de que lado do muro você está construindo.
Pronto para decidir? Comece com créditos de teste grátis: Agende uma ligação