

Autres outils
Cas d'usage


L'économie des créateurs a un problème de données. Le volume de contenu social généré chaque jour est vertigineux (il devrait soutenir un marché de 480 milliards de dollars d'ici 2027), et pourtant l'accès à ces données n'a jamais été aussi difficile. Les plateformes renforcent leurs jardins clos. Les API officielles limitent et restreignent. Les outils de scraping deviennent obsolètes du jour au lendemain.
Ce qui rend la situation particulièrement complexe pour le développement de l'IA, c'est le basculement vers des workflows agentiques. Les agents d'IA n'interrogent pas les API comme les humains cliquent sur des boutons. Ils prennent des décisions probabilistes et autonomes sur les données à récupérer, le moment où les récupérer et la manière d'enchaîner les résultats sur plusieurs appels d'outils. Il faut aussi tenir compte du déficit de découvrabilité. C'est le décalage fondamental entre l'exploration à l'échelle de l'IA et l'accès aux données contrôlé par des intermédiaires humains.
Modash repose sur un pipeline qui indexe en continu plus de 350 millions de profils sur Instagram, TikTok et YouTube. Lorsqu'un développeur ou un agent d'IA soumet une requête, la réponse revient en quelques millisecondes à partir d'une base de données structurée déjà optimisée. C'est ce qui se rapproche le plus, sur le marché, d'une couche de données clé en main pour l'IA.
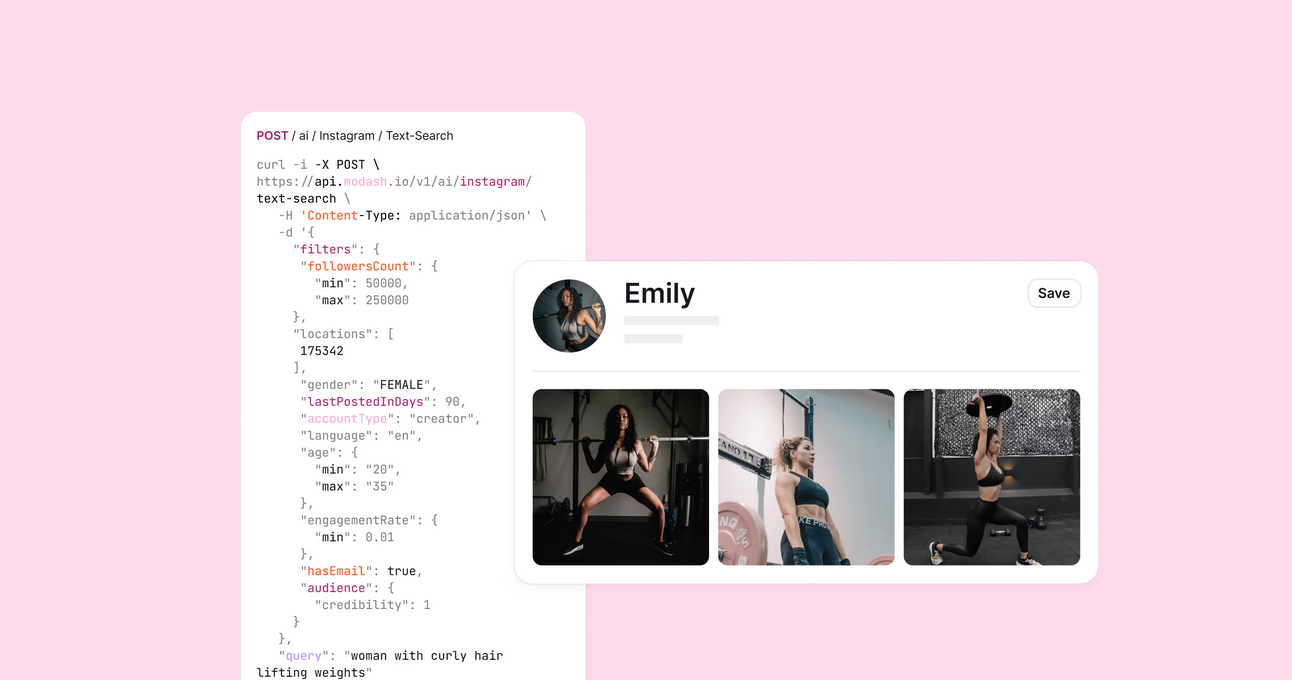
La recherche sémantique mérite d'être soulignée en particulier. Comme Modash indexe le texte intégral des bios, des légendes et des hashtags ainsi que les métadonnées visuelles, un agent peut rechercher un concept comme "mères actives vivant durablement à Paris" et faire remonter des créateurs pertinents. Le moteur de profils similaires va encore plus loin : fournissez un profil de départ, et l'API renvoie des créateurs statistiquement similaires sur la base du chevauchement du graphe et de la similarité du contenu. Il existe aussi une configuration à double API avec une API Discovery prétraitée pour la récupération RAG et un flux Raw API pour les commentaires en direct et les métadonnées des publications.
Influencers.club couvre 340 millions de profils sur 47 plateformes, dont Discord, Patreon, Twitch et Reddit. Il est conçu pour les équipes qui ont besoin d'une vue complète de l'empreinte numérique d'un créateur sans devoir assembler des dizaines d'intégrations distinctes.
Data365 n'est pas du tout une plateforme marketing. C'est une infrastructure d'extraction. Il fournit du JSON non structuré pour les publications, les commentaires et les profils sur Instagram, Twitter, Reddit, TikTok et LinkedIn.
HypeAuditor suit 219 millions de profils sur cinq plateformes, à l'aide de modèles de ML entraînés spécifiquement pour détecter l'engagement artificiel. Pour les agents IA qui créent des listes de prospection de manière autonome, le point de terminaison Audience Quality Score agit comme un contrôle qualité programmatique.
Storyclash apporte la recherche visuelle neuronale à la découverte de créateurs. Transmettez une image de référence ou une URL de produit, et l'API renvoie des créateurs produisant un contenu visuellement et contextuellement similaire. Il archive également du contenu comme les Stories Instagram, ce qui permet aux agents IA d'analyser des placements de campagne temporaires qui disparaîtraient autrement.
Influship adopte une approche différente de la plupart des fournisseurs : un accès ouvert avec un minimum de barrières d'authentification. Il se concentre sur Instagram et suit environ 5 millions de créateurs, en privilégiant la rapidité et la recherche en langage naturel plutôt qu'une large couverture multiplateforme. L'API est spécialement conçue pour alimenter des programmes de prospection évolutifs et s'intégrer à des workflows CRM personnalisés avec une configuration minimale.
Kuli est moins une API de données qu'un moteur d'intelligence de découverte. Son système Video Intelligence analyse le contenu image par image, en extrayant des signaux de qualité comme les taux de visionnage complet, la trajectoire de production et les marqueurs d'authenticité.
Phyllo est architecturalement différent de tous les autres fournisseurs de cette liste. C'est une passerelle OAuth qui exige que le créateur s'authentifie et accorde au développeur un accès first-party à des données privées. Cela en fait le bon choix pour des environnements à forts enjeux comme le rapprochement des revenus en temps réel.
Choisir la bonne API ne résout que la moitié du problème. La manière dont vous la connectez à un agent IA est tout aussi importante. Insérer un appel d'API REST dans un prompt en texte brut en espérant que le LLM déduise les paramètres est une voie sûre vers les hallucinations, les valeurs inventées et des crédits d'API gaspillés. Il existe trois approches qui méritent d'être connues.
La passerelle MCP
L'approche la plus pérenne consiste à créer un serveur MCP comme intermédiaire standardisé entre le LLM et l'API de données de créateurs. Au lieu d'écrire des wrappers personnalisés dans la logique de l'application, le serveur MCP expose les points de terminaison de l'API comme des outils nommés avec des schémas définis.
Appel d'outils et de fonctions
Pour des systèmes plus petits et plus circonscrits, comme un copilote intégré unique, l'appel direct de fonctions est une option raisonnable. Les LLM modernes sont bien entraînés à produire des schémas JSON structurés, donc encapsuler un point de terminaison Influencers.club ou Influship dans une définition de fonction typée fonctionne généralement.
Orchestration agent à agent (A2A)
Pour les workflows plus complexes, la bonne approche consiste à décomposer le travail en micro-agents spécialisés plutôt que de charger un seul agent de l'ensemble de la tâche. La configuration à double API de Modash permet d'exécuter une version pertinente de cela entièrement chez un seul fournisseur. Un agent de découverte utilise le point de terminaison de recherche sémantique pour extraire une liste structurée de profils correspondants à partir d'une requête conceptuelle. Un agent Lookalike sélectionne ensuite le résultat le plus performant de cette liste, l'injecte dans le moteur lookalike et élargit le pool avec des créateurs statistiquement similaires.
Chaque agent gère une tâche plus petite et plus ciblée, ce qui réduit le risque d'hallucinations et facilite le débogage du système. Lorsque le workflow doit aller plus loin (scoring de fraude, enrichissement d'e-mails, prospection), vous ajoutez HypeAuditor ou Influencers.club à la fin de la chaîne.
La plupart des cas d'usage renvoient à une poignée de fournisseurs. Voici la version courte :
Le défi des données de la creator economy ne va pas disparaître. Les plateformes continueront à restreindre l'accès, l'IA rendra la découverte plus précieuse, et le coût de maintenance du scraping ne fera que s'accumuler. La paresse architecturale coûte cher dans cet environnement.
Les données sont à la fois une commodité et un fossé défensif. Les équipes qui gagnent ne sont pas celles qui en collectent le plus. Ce sont celles qui ont choisi une architecture leur permettant de se concentrer sur la création de ce que leurs utilisateurs valorisent réellement. Ne demandez pas "Quelle API est la moins chère ?" Demandez "Quelle API permet réellement à mon agent IA de fonctionner ?"
Les jardins clos continueront à murer davantage leurs portes. Votre choix d'infrastructure de données détermine de quel côté du mur vous construisez.
Prêt à décider ? Commencez avec des crédits d'essai gratuits : Réserver un appel