

Altri tool
Casi d'uso


La creator economy ha un problema di dati. Il volume di contenuti social generati ogni giorno è impressionante (si prevede che sosterrà un mercato da 480 miliardi di dollari entro il 2027), eppure accedere a questi dati non è mai stato così difficile. Le piattaforme rafforzano i propri giardini recintati. Le API ufficiali limitano e impongono restrizioni. Gli strumenti di scraping invecchiano da un giorno all'altro.
Ciò che rende tutto questo particolarmente complesso per lo sviluppo dell'IA è il passaggio verso flussi di lavoro agentici. Gli agenti di IA non interrogano le API nel modo in cui gli esseri umani cliccano sui pulsanti. Prendono decisioni probabilistiche e autonome su quali dati recuperare, quando recuperarli e come concatenare i risultati attraverso più chiamate agli strumenti. C'è anche il problema del gap di scoperta da considerare. È il disallineamento fondamentale tra l'esplorazione alla scala dell'IA e l'accesso ai dati controllato dagli esseri umani.
Modash funziona su una pipeline che indicizza continuamente oltre 350 milioni di profili su Instagram, TikTok e YouTube. Quando uno sviluppatore o un agente di IA invia una query, la risposta arriva in millisecondi su un database già ottimizzato e strutturato. È quanto di più simile il mercato offra a un layer dati chiavi in mano per l'IA.
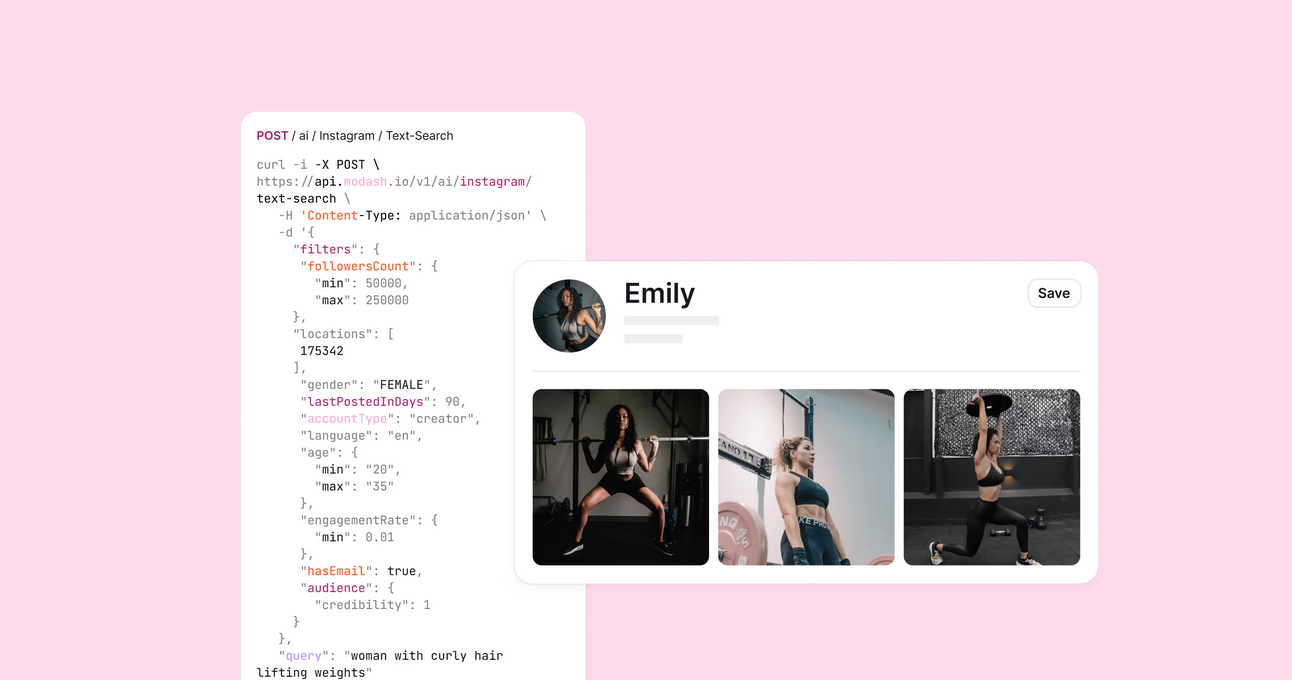
Vale la pena evidenziare in particolare la ricerca semantica. Poiché Modash indicizza il testo completo di bio, caption e hashtag insieme ai metadati visivi, un agente può interrogare un concetto come "mamme lavoratrici a Parigi che vivono in modo sostenibile" e far emergere creator pertinenti. Il motore lookalike estende ulteriormente questa capacità: inserisci un profilo di partenza e l'API restituisce creator statisticamente simili sulla base della sovrapposizione del grafo e della somiglianza dei contenuti. C'è anche una configurazione API doppia con una Discovery API pre-elaborata per il recupero RAG e un flusso Raw API per commenti in tempo reale e metadati dei post.
Influencers.club copre 340 milioni di profili su 47 piattaforme, tra cui Discord, Patreon, Twitch e Reddit. È pensato per team che hanno bisogno di una visione completa dell'impronta digitale di un creator senza dover mettere insieme decine di integrazioni separate.
Data365 non è affatto una piattaforma di marketing. È un'infrastruttura di estrazione. Fornisce JSON non strutturato per post, commenti e profili su Instagram, Twitter, Reddit, TikTok e LinkedIn.
HypeAuditor monitora 219 milioni di profili su cinque piattaforme, utilizzando modelli ML addestrati specificamente per rilevare l'engagement artificiale. Per gli agenti AI che costruiscono liste di outreach in autonomia, l'endpoint Audience Quality Score funge da controllo qualità programmatico.
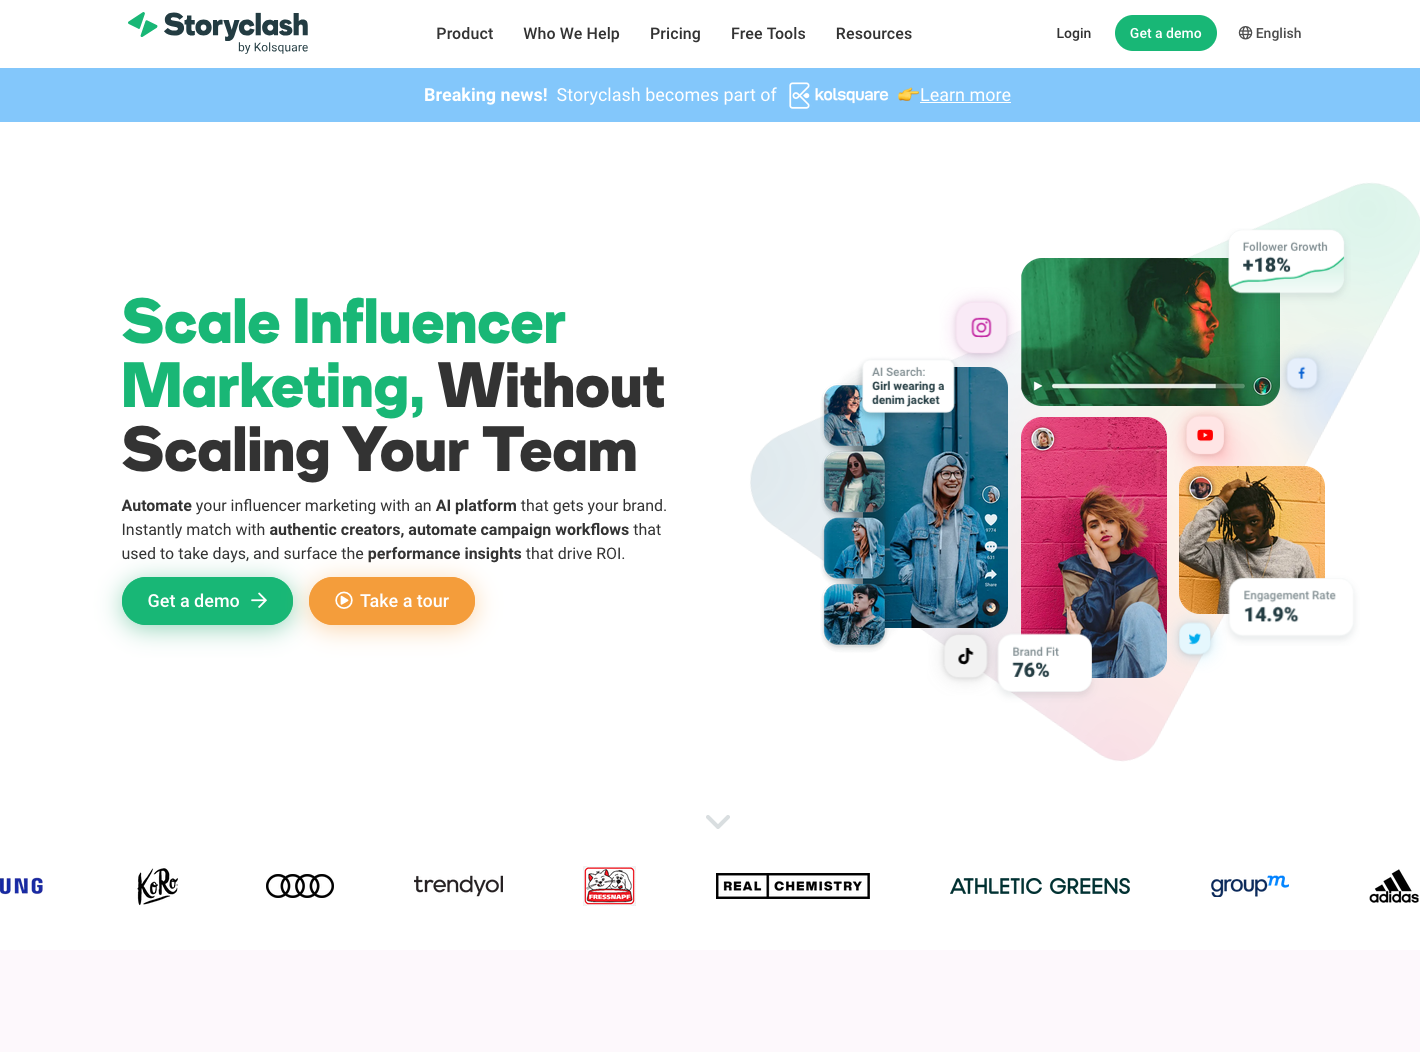
Storyclash porta la ricerca visiva neurale nella scoperta dei creator. Passa un'immagine di riferimento o un URL di prodotto e l'API restituisce creator che generano contenuti visivamente e contestualmente simili. Archivia anche contenuti come le Instagram Stories, permettendo agli agenti AI di analizzare posizionamenti di campagna temporanei che altrimenti scomparirebbero.
Influship adotta un approccio diverso dalla maggior parte dei provider: accesso aperto con barriere di autenticazione minime. Si concentra su Instagram e monitora circa 5 milioni di creator, dando priorità alla velocità e alla ricerca in linguaggio naturale rispetto a un'ampia copertura multipiattaforma. L'API è progettata specificamente per alimentare programmi di outreach scalabili e integrarsi in workflow CRM personalizzati con una configurazione minima.
Kuli è meno una data API e più un motore di intelligence per la scoperta. Il suo sistema Video Intelligence analizza i contenuti fotogramma per fotogramma, estraendo segnali di qualità come tassi di completamento della visione, traiettoria produttiva e indicatori di autenticità.
Phyllo è architetturalmente diverso da tutti gli altri provider di questo elenco. È un gateway OAuth che richiede al creator di autenticarsi e concedere allo sviluppatore un accesso first-party ai dati privati. Questo lo rende la scelta giusta per ambienti ad alta criticità come la riconciliazione dei ricavi in tempo reale.
Scegliere l'API giusta è solo metà del problema. Il modo in cui la colleghi a un agente AI conta altrettanto. Inserire una chiamata API REST in un prompt in testo semplice e sperare che l'LLM capisca i parametri è una strada sicura verso allucinazioni, valori inventati e crediti API sprecati. Ci sono tre pattern che vale la pena conoscere.
Il gateway MCP
L'approccio più a prova di futuro è costruire un server MCP come intermediario standardizzato tra l'LLM e l'API di dati sui creator. Invece di scrivere wrapper personalizzati all'interno della logica applicativa, il server MCP espone gli endpoint API come strumenti nominati con schemi definiti.
Tool calling e function calling
Per sistemi più piccoli e circoscritti, come un singolo copilota in-app, il function calling diretto è un'opzione ragionevole. Gli LLM moderni sono ben addestrati a produrre schemi JSON strutturati, quindi racchiudere un endpoint di Influencers.club o Influship in una definizione di funzione tipizzata generalmente funziona.
Orchestrazione agent-to-agent (A2A)
Per workflow più complessi, il pattern giusto è suddividere il lavoro in micro-agenti specializzati anziché caricare un singolo agente con l'intero compito. La configurazione dual API di Modash consente di eseguire una versione significativa di questo interamente all'interno di un singolo provider. Un Discovery Agent usa l'endpoint di ricerca semantica per estrarre un elenco strutturato di profili corrispondenti sulla base di una query concettuale. Un Lookalike Agent seleziona quindi il risultato con le migliori performance da quell'elenco, lo passa al motore lookalike ed espande il pool con creator statisticamente simili.
Ogni agente gestisce un compito più piccolo e mirato, riducendo il rischio di allucinazioni e rendendo il sistema più facile da sottoporre a debug. Quando il workflow deve andare oltre (fraud scoring, email enrichment, outreach), aggiungi HypeAuditor o Influencers.club alla fine della catena.
La maggior parte dei casi d'uso rimanda a uno di una manciata di provider. Ecco la versione breve:
La sfida dei dati della creator economy non scomparirà. Le piattaforme continueranno a limitare l'accesso, l'AI renderà la scoperta più preziosa e il costo di manutenzione dello scraping non farà che aumentare. La pigrizia architetturale è costosa in questo contesto.
I dati sono sia una commodity sia un vantaggio competitivo difendibile. I team che vincono non sono quelli che ne raccolgono di più. Sono quelli che hanno scelto un'architettura che permette loro di concentrarsi sulla costruzione di ciò che i loro utenti apprezzano davvero. Non chiedere "Quale API è più economica?" Chiedi "Quale API fa davvero funzionare il mio agente AI?"
I giardini recintati continueranno a murare i loro cancelli. La tua scelta dell'infrastruttura dati determina da quale lato del muro stai costruendo.
Pronto a decidere? Inizia con crediti di prova gratuiti: Prenota una call